Asupra datelor din "Orarul general clase"
[1] Pachetele R days2lessons, hours2lessons și refitgaps
Orarul unei școli se construiește pe baza încadrării profesorilor pe obiecte și pe clase, exprimate cel mai bine printr-un tabel conținând valorile prof|obj|cls, unde prof codifică în vreun fel numele profesorilor angajați în școala respectivă, obj codifică în vreun fel disciplinele școlare, iar cls reprezintă clasele existente în acea școală. Orarul respectiv — adică o alocare pe zilele de lucru și pe ore a lecțiilor din încadrare, cu proprietatea că oricare două lecții nu se suprapun — este produs de obicei prin aplicația ascTimetables (în versiunea "aSc Orare" pusă la dispoziție de către Minister) și este redat, de obicei, prin două fișiere în format PDF, intitulate "Orarul general clase" și "Orarul general profesori", postate de obicei pe site-ul școlii respective.
Consultând (de obicei de pe telefon, expeditiv) "Orarul general clase" (PDF), elevii școlii află ce lecții au de făcut în fiecare zi (și în ce ordine); consultând "Orarul general profesori" (PDF), profesorii școlii află la care clase au de intrat, pe zile și ore.
Dar orarul școlii — reflectând activitatea principală din școala respectivă și sugerând într-o anumită măsură calitatea acesteia — poate să intereseze și persoane din afara școlii; ce părere are un părinte, sau un inspector școlar, văzând în orar că la unele clase cele 3 sau 4 lecții de română, sau de matematică etc., se expediază în două zile? Ce părere are, observând cazuri de profesori cu multe ore, dar înghesuite în mai puține zile (ca să aibă măcar o zi liberă)? Ce părere are careva, observând fel de fel de zorzoane grafice cu care este redat de obicei orarul, sau fel de fel de nume de obiecte, despărțite uneori pe două rânduri, în celula respectivă? Dar dacă observă cumva că numele (profesorilor, obiectelor) sunt redate fără diacritice?
De câțiva ani, eu unul am fost interesat de orarele unor școli pentru a pune la punct un set de pachete R, prin care, pentru o încadrare prof|obj|cls dată, să obțin orare echilibrate (și cu număr rezonabil de ferestre). Desigur, încadrarea dorită nu era dată, ci trebuia dedusă de pe fișierele PDF respective — încât a devenit o problemă în sine, desprinderea din imaginile PDF a datelor propriu-zise.
Dar în ultimul timp nu mai găsești pe site-uri decât "Orar general clase", încât nu mai poți reconstitui încadrarea profesorilor din școala respectivă… Dar și un asemenea "orar" (al vreunei școli "fără profesori") poate fi interesant; vom arăta aici cum obținem, folosind R, informații privitoare la disciplinele școlare, utile apoi într-o anumită reformulare și organizare, unor programe de elaborare a orarului.
Am ales orarul unei școli cu foarte multe clase (probabil și mulți profesori); redăm de pe fișierul PDF respectiv, ca să avem aici o exemplificare, numai fragmente de pe primele rânduri din prima pagină și ultimele rânduri din a patra pagină:
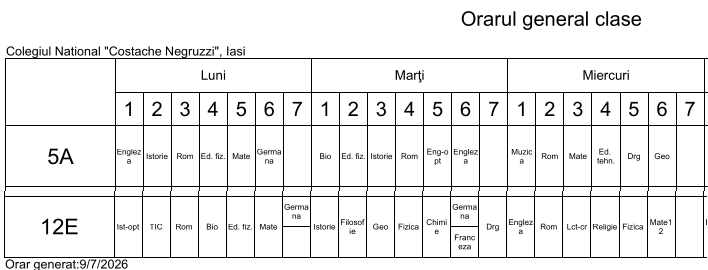
Filând fișierul PDF respectiv am constatat că sunt câte 5 clase (A:E) pe fiecare nivel 5:12, deci în total sunt 40 de clase (toate într-un același schimb, fiindcă orele sunt indicate prin 1:7); am mai observat că pe obiectele cu "juma' de oră/săptămână" (de obicei, "Muzică" și "Desen") și pe limbi străine s-au constituit anumite cuplaje și anumite tuplaje (sugerate vizual, prin împărțirea celulei de tabel în subcelule).
Fișierul PDF respectiv este decent, adică lipsit de zorzoane stilistice (precum fel de fel de culori și grosimi de linie și fel de fel de grupări de celule) — încât chiar a fost ușor să desprind datele: prin iLovePDF am obținut (încă gratis, la acest moment) fișierul .xlsx asociat fișierului PDF inițial; apoi, din Gnumeric am obținut din fișierul în format .xlsx respectiv, fișierul-text în format CSV, "elevi.csv", conținând pe linii toate datele pozate pe fișierul PDF inițial.
Bineînțeles că în "elevi.csv" am eliminat liniile "Orarul..." și "Colegiul..." și am înlocuit liniile 3 și 4 cu o linie de antet CSV, "cls,Lu1,Lu2, ..., Vi5,Vi6" (folosind în acest scop un editor de text decent, de exemplu gEdit). Înloc de înscrisurile din celulele grafice ale tabelului PDF inițial, bune doar de citit cu ochii și de printat, acum, în "elevi.csv", datele apar pentru fiecare clasă pe câte o linie de text, fiind separate între ele prin virgulă ("CSV" înseamnă "Comma Separated Values"):
5A,"Englez a",Istorie,Rom,"Ed. fiz.",Mate,"Germa na",,Bio,"Ed. fiz.",Istorie,Rom,"Eng-o pt","Englez a",,"Muzic a",Rom,Mate,"Ed. tehn.",Drg,Geo,,Mate,Rom,"info-TI C",Religie,"Germa na",,,Rom,"Eng-o pt","Ed. soc.",Mate,"Ed. plastic a",,
Am marcat aici valorile care de obicei în formatul CSV (pentru a nu încurca vreo prelucrare automată ulterioară) sunt ambalate cu ghilimele, fiind compuse din mai multe cuvinte sau părți de cuvânt, separate cu spațiu sau cu "\n". Mai departe, pentru corecturi și anumite prelucrări de date, am folosit R:
library(tidyverse)
CNZ <- read.csv("elevi.csv")
CNZ <- CNZ %>% apply(., 2, str_remove_all, " ") %>%
       as.data.frame()  # transformă "Ed. plastic a" în "Ed.plastica", etc.
CNZ <- CNZ %>% apply(., 2, str_remove_all, "\\n") %>%
       as.data.frame()  # transformând "L.franc\n-opt" în "L.franc-opt"
saveRDS(CNZ, "elevi.RDS")
Fișierul rezultat "elevi.RDS" conține (în format comprimat) o listă de tip data.frame, structurată cum exemplificăm aici:
> str(CNZ)
'data.frame':	59 obs. of  36 variables:
 $ cls: chr  "5A" "5B" "5C" "5D" ...
 $ Lu1: chr  "Engleza" "Mate" "Muzica" "Rom" ...
 $ Lu2: chr  "Istorie" "Engleza" "Ed.tehn." "Lct-v" ...
# ... etc.
 $ Vi5: chr  "Ed.plastica" "Germana" "Ed.soc." "Istorie" ...
 $ Vi6: chr  "" "" "Ed.fiz." "" ...
 $ Vi7: chr  "" "" "" "" ...
Sunt 36 de "variables" (sau coloane de date) fiindcă pe una (prima) s-au înregistrat clasele și pe fiecare dintre celelalte s-a înregistrat câte o disciplină, corespunzător lecțiilor din fiecare dintre cele 5 zile de lucru, pe fiecare dintre cele maximum 7 ore ale zilei respective. Sunt 59 de "obs." (sau linii de date), fiindcă pentru unele dintre cele 40 de clase s-au "postat" câte două linii de date, înloc de una singură (la trecerea din formatul .xlsx în format CSV, rândurile care conțin celule despărțite vertical în două subcelule sunt mapate pe două linii de text, a doua înregistrând conținuturile subcelulelor aflate dedesubt în celulele respective; din fericire în cazul de față nu avem și celule colapsate orizontal — exceptând liniile omise, "Orarul..." și "Colegiul..." — caz în care cam trebuia să înscriem manual, conținutul subcelulei din dreapta).
Cu alte cuvinte, "orarul general clase" a devenit un "tabel" cu 59 de linii de text și 36 de coloane, identificat în memorie prin numele ales mai sus "CNZ"; regulile de exploatare a acestei structuri de date sunt foarte firești: CNZ[i, j] accesează valoarea existentă în linia i și coloana j; CNZ[i, ] ne dă vectorul constituit de toate valorile existente pe linia i (analog, CNZ[, j]); orarul clasei 5A pe ziua Lu poate fi extras prin CNZ[1, 2:8]; iar CNZ$cls ne dă vectorul tuturor valorilor din coloana cu numele cls.
Dar care sunt de fapt, datele cu care avem de-a face?
Pe de o parte, sunt zilele de lucru desemnate prin Lu, Ma, etc. și orele zilei, desemnate prin enumerarea 1:7 — și se cuvine să observăm că aceste date sunt deocamdată "amestecate", concatenând câte o zi și câte o oră (Lu1, Lu2, etc.).
Pe de altă parte, avem disciplinele care se fac la fiecare clasă în fiecare zi și oră — dar să observăm că o aceeași disciplină (de exemplu "Rom") figurează la mai multe clase, în mai multe coloane; care ar fi de fapt, ca date, disciplinele care se fac în școala respectivă, fiecare la una sau mai multe clase, într-una sau mai multe zile și ore? Cea mai simplă rezolvare constă în "de-listarea" listei CNZ (obținând un vector care conține toate valorile din "tabel") și apoi, ignorarea duplicatelor:
> NU <- unlist(CNZ, use.names = FALSE) %>%
        unique()  # numele unice, conținute în "tabelul" CNZ
> NU
     [1] "5A"          "5B"          "5C"          "5D"          "5E"
     [6] "6A"          "6B"          "6C"          "6D"          "6E"
    [11] "7A"          "7B"          "7C"          "7D"          "7E"
    [16] "8A"          "8B"          "8C"          "8D"          "8E"
    [21] "9A"          ""            "9B"          "9C"          "9D"
    [26] "9E"          "10A"         "10B"         "10C"         "10D"
    [31] "10E"         "11A"         "11B"         "11C"         "11D"
    [36] "11E"         "12A"         "12B"         "12C"         "12D"
    [41] "12E"         "Engleza"     "Mate"        "Muzica"      "Rom"
    [46] "info-TIC"    "Ed.tehn."    "Fizica"      "Ed.fiz."     "Ed.plastica"
    [51] "Mate7"       "Lct-v"       "Lct-cr"      "Chimie"      "Jurn"
    [56] "Bio"         "TIC"         "Germana"     "Franceza"    "Bio-opt"
    [61] "Istorie"     "Latina"      "Info"        "Ist-opt"     "Eng-opt"
    [66] "Geo"         "L.germ-opt"  "Mate8"       "Stiinte"     "Mate11"
    [71] "Economie"    "Lu"          "Drg"         "Psihologie"  "Mate12"
    [76] "Filosofie"   "Religie"     "Ed.soc."     "Rbz"         "Logica"
    [81] "Ch-opt"      "L.franc-opt"
De aici, pe de o parte avem imediat vectorul celor 40 clase existente în școală:
Cls <- NU [1:41] [-22]
Am exclus valoarea vidă de pe rangul 22, corespunzătoare celei de-a doua linii de date existente în cazul unora dintre clase (începând de la clasa 9A, cum deducem din succesiunea valorilor redate mai sus).
Pe de altă parte, începând de la rangul 42 și până la rangul final 82, în vectorul NU avem denumirile disciplinelor pe care au fost angajați profesorii școlii. Să ignorăm deocamdată faptul că o aceeași disciplină are eventual, mai multe denumiri distincte între ele (cazul disciplinei "Mate", cu variante ca "Mate7", "Mate8" și altele).
Conchidem că datele propriu-zise sunt valorile posibile ale variabilelor independente cls, zl, ora și obj; profesorii vor avea de făcut câte o lecție la o anumită cls, într-o anumită zl și ora, pe o anumită disciplină obj.
Să restrucurăm "tabelul" CNZ, astfel încât să evidențiem lecțiile cls|obj|zl|ora…
Deocamdată să ținem seama de faptul că, din motive pe care urmează să le investigăm mai târziu, pentru unele clase, în CNZ avem câte două linii de date, înloc de câte una singură, iar în fiecare dintre cazurile respective, în câmpul cls din a doua linie aferentă clasei avem ca valoare "" (șirul vid):
> Id2 <- which(CNZ$cls == "")  # indecșii liniilor cu $cls vid
> Id2
     [1] 22 24 26 28 30 32 34 36 38 40 42 44 46 48 50 52 55 57 59
La indexul de linie 26 avem un caz tipic mai simplu de elucidat:
> CNZ[25:26, c(1, 9:15)]
       cls    Ma1     Ma2 Ma3      Ma4  Ma5 Ma6 Ma7
    25  9C Logica Engleza Rom  Germana Mate
    26                        Franceza
Am redat aici fragmente de pe liniile 25 și 26, care corespund clasei 9C; linia 26 conține (în fragmentul redat) un singur item, "Franceză", poziționat în ziua Ma, ora a 4-a, în care pe linia 25 avem "Germană" (bine… nu se știe de literele românești, dar nici nu are importanță — putem denumi disciplinele cum dorim, important este să le distingem între ele și să fim consecvenți, adică să nu înscriem "Ed.fiz" și apoi într-un alt loc "Ed.fiz.", de exemplu).
Explicația este simplă: când Gnumeric (sau altă aplicație uzuală de tip "spreadsheet") a convertit din format .xlsx în format CSV, a observat că celula de tabel corespunzătoare zilei Ma și orei a 4-a a fost împărțită vizual în două subcelule și a reținut pe linia 25 conținutul primei subcelule, iar pe linia 26 a consemnat conținutul celeilalte subcelule, aflate dedesubtul primeia.
Iar interpretarea uzuală este aceasta: în ziua și ora respectivă, elevii clasei respective (9C) sunt separați în două grupe; una dintre ele face "Germană" cu un anumit profesor, iar cealaltă face cu alt profesor, "Franceză" (și eventual invers, în săptămâna următoare) — adică avem de-a face cu un cuplaj (doi profesori fac într-un același timp, câte o lecție cu numai câte o grupă a unei aceleiași clase). Dar se poate să găsim și o a doua clasă, care în aceeași zi și oră ca la clasa 9C, face deasemenea "Germană/Franceză" și e de presupus că e vorba de aceiași doi profesori; aceasta înseamnă că se constituie două "noi" clase, din câte o grupă din cele două clase inițiale și la una dintre noile clase intră cel de "Germană" iar la cealaltă intră cel de "Franceză".
Putem elimina linia 26, cuplând-o cu linia 25; de exemplu, în cazul fragmentului de linie redat mai sus, am reține pe linia 25 în coloana "Ma4", cuplajul "Germana/Franceză" (în loc de "Germană" cum aveam inițial).
Vom folosi caracterul "/" pentru a indica faptul că într-o oră a zilei, clasa este împărțită în grupe (două de obicei, sau mai multe); în cel mai general caz, o grupă a unei clase poate fi eventual combinată în ora respectivă cu grupe ale altor clase, pentru ca împreună să facă o lecție cu un anumit profesor.
Pentru cazurile în care clasa este implicată în cuplaje sau în tuplaje — încât în CNZ îi corespund două linii consecutive — îmbinăm prin "/", disciplinele dintr-o aceeași oră de pe cele două linii:
for(id in Id2) {
    v1 <- CNZ[id-1, ]  # linia clasei
    v2 <- CNZ[id, ]  # linia de cuplaje/tuplaje care implică clasa
    for(j in which(v2 != "")) {
        if(v1[j] == "") {
            CNZ[id-1, j] <- paste0("/", v2[j], collapse = "")
        } else {
            CNZ[id-1, j] <- paste0(CNZ[id-1, j], "/", v2[j], collapse = "")
        }
    }
}
Acum putem elimina liniile auxiliare (cele cu "" în câmpul cls) și putem restructura datele încât să corespundă lecțiilor cls|zl|ora|obj:
Zile <- c("Lu", "Ma", "Mi", "Jo", "Vi")
CN <- CNZ %>% filter(cls != "") %>%
      pivot_longer(2:36,
                   names_to = "ziOra",
                   values_to = "obj") %>%
      separate(ziOra, c("zl", "ora"), sep = 2) %>%
      filter(obj != "") %>%  # ignoră celulele vide
      mutate(ora = as.integer(ora),
             zl = factor(zl, levels = Zile, ordered = TRUE))
glimpse(CN)  # inspectăm setul de date rezultat
Rows: 1222
Columns: 4
$ cls <chr> "5A", "5A", "5A", "5A", "5A", "5A", "5A", "5A", "5A", "5A", "5A", …
$ zl  <ord> Lu, Lu, Lu, Lu, Lu, Lu, Ma, Ma, Ma, Ma, Ma, Ma, Mi, Mi, Mi, Mi, Mi…
$ ora <int> 1, 2, 3, 4, 5, 6, 1, 2, 3, 4, 5, 6, 1, 2, 3, 4, 5, 6, 1, 2, 3, 4, …
$ obj <chr> "Engleza", "Istorie", "Rom", "Ed.fiz.", "Mate", "Germana", "Bio", …
În setul de date rezultat, fiecare linie reprezintă câte o singură "lecție"; din inspecția redată mai sus rezultă că în școala respectivă se desfășoară în total cam 1222 de lecții (de fapt, ceva mai puține, fiindcă lecțiile cuplate apar de câte două ori). Apare un prim avantaj (dar nicidecum cel mai important) al reprezentării datelor în "format lung": în reprezentarea tabelată inițială, lecțiile erau reprezentate pe 35×40=1400 de celule, dintre care multe erau vide.
Fiindcă am introdus și cuplajele (prin "/"), apar acum mai multe "discipline", fiecare pe câte un anumit număr de ore:
> table(CN$obj) %>% sort() %>% t()
       /Muzica Rbz /Ed.plastica Jurn  Lu Germana/L.germ-opt L.franc-opt Mate11
  [1,]       1   1            2    2   2                  3           3      3
       Mate12 Mate7 Ed.plastica/Muzica Mate8 Muzica/Ed.plastica Stiinte
  [1,]      3     3                  4     4                  4       4
       /Franceza Bio-opt Economie Filosofie Logica L.germ-opt Ist-opt Lct-cr
  [1,]         6       6        6         6      6          8       9      9
       Latina Ch-opt Psihologie TIC Franceza Lct-v Ed.soc. Ed.tehn. info-TIC
  [1,]     10     11         11  15       16    18      20       20       20
       Ed.plastica Muzica Eng-opt Germana/Franceza Germana Info Drg Religie
  [1,]          24     25      26               27      32   35  38      40
       Chimie Geo Bio Istorie Ed.fiz. Fizica Engleza Mate Rom
  [1,]     47  51  56      56      66     81      84  147 151
Ne uităm și noi, dar din afară — nicidecum ca un elev al școlii, care vrea să vadă ce lecție face într-o anumită zi și oră — la denumirile astea de "discipline școlare"… Pe obiectul Rbz (probabil pentru "Robotizare/Robotică") există în tot orarul respectiv o singură oră (și o putem identifica filtrând CN pentru obj=="Rbz"); socotim atunci că Rbz este o disciplină secundară, adăugată în încadrarea vreunui profesor a cărui disciplină principală este "Informatică" (sau, cu denumirile de mai sus, "Info", sau "info-TIC", sau poate "TIC"). O situație similară avem pentru obiectele "Jurn" (probabil "Jurnalism", adăugată ca disciplină secundară, pe două ore, vreunui profesor de "Rom"), "Lu" (tot cu două ore) și chiar pentru obiectele "opționale" ("Ist-opt", "L.germ-opt" etc.), ca și pe cele ca "Mate7", "Mate8", etc. (care ar fi "secundare" pentru disciplina "Mate").
Cu alte cuvinte, lista disciplinelor propriu-zise s-ar reduce la disciplinele principale (păstrând separat și informațiile, necesare la redarea orarului, privitoare la disciplinele "secundare"), iar profesorii (dacă există, că în cazul de față nu există) ar putea fi desemnați prin abrevieri de câte două litere ale disciplinelor principale pe care au fost încadrați (plus un număr de ordine între cei de pe o aceeași disciplină).
În cazul de față nu mai putem progresa, fiindcă nu dispunem de fișierul PDF "Orarul general profesori" (putem doar inventa profesorii necesari — cum am și făcut anterior undeva pe aici — atribuindu-le discipline și clase astfel încât să nu apară suprapuneri pe lecțiile aflate în setul CN; de exemplu, pentru Rom plus Jurn și Lu, pe care avem 151+2+2 lecții, ar fi necesari 8 profesori, fiecare cu circa 20 de ore)…
Ar mai fi interesant doar să evidențiem cuplajele și tuplajele de lecții…
Desigur "Ed.plastica/Muzica" și "Muzica/Ed.plastica" reprezintă un același cuplaj și le putem unifica; să observăm totuși lecțiile respective:
> CN %>% filter(obj == "Ed.plastica/Muzica") %>% arrange(zl, ora)
      cls   zl      ora obj
    1 9D    Lu        2 Ed.plastica/Muzica
    2 10B   Ma        6 Ed.plastica/Muzica
    3 10D   Mi        6 Ed.plastica/Muzica
    4 10E   Jo        5 Ed.plastica/Muzica
> CN %>% filter(obj == "Muzica/Ed.plastica") %>% arrange(zl, ora)
      cls   zl      ora obj
    1 10A   Lu        2 Muzica/Ed.plastica
    2 10C   Ma        6 Muzica/Ed.plastica
    3 11D   Mi        6 Muzica/Ed.plastica
    4 9C    Jo        5 Muzica/Ed.plastica
Constatăm că există patru perechi de clase, încât clasele dintr-o aceeași pereche fac fie "Ed.plastica", fie "Muzica", într-o aceeași zi și oră. Altfel spus, avem de-a face cu patru tuplaje. În general, un tuplaj este constituit dintr-un număr de clase și un același număr de profesori; elevii claselor respective sunt redistribuiți ad-hoc pentru a forma "noi" clase (păstrând numărul de clase inițial), la care va intra câte unul dintre profesorii respectivi, în câte o aceeași zi și oră.
În cazul de aici, clasele 9D și 10A, împreună cu doi profesori, "Mz1" și "Ds1", formează un tuplaj: în ziua Lu ora 2, "Mz1" intră la 9D și face "Muzică", iar "Ds1" intră la 10A și face "Desen" (sau invers, dacă ținem cont de paritatea rangului săptămânii curente). Analog avem tuplajul (10B 10C)|(Mz1 Ds1), etc.
La fel ne putem lămuri și asupra tuplajelor existente pe cele două limbi străine, dar nu este cazul de a mai insista aici (mai ales că între timp, am observat pe site-ul școlii că "Orarul general clase" a fost deja modificat).
vezi Cărţile mele (de programare)